
Quem acompanha exploração espacial sabe que a Lua ficou um bom tempo sem visita humana — nada de botas na poeira desde 1972. Esse jejum terminou neste ano. Em 6 de abril, a missão Artemis II levou Reid Wiseman, Christina Koch, Victor Glover e Jeremy Hansen mais longe da Terra do que qualquer ser humano já havia ido, num sobrevoo lunar histórico. Agora a NASA começa a preparar o terreno para as próximas etapas do programa, e para isso chamou a IBM para ajudar.
Na última quinta-feira, as duas instituições anunciaram o NASA-IBM Lunar Foundation Model, um sistema de inteligência artificial de código aberto, disponível para download no Hugging Face. Sem custo e sem letras miúdas — inclusive para pesquisadores por aqui, no Brasil, que podem baixar o modelo e testar em seus próprios projetos.
O que faz um modelo de fundação lunar
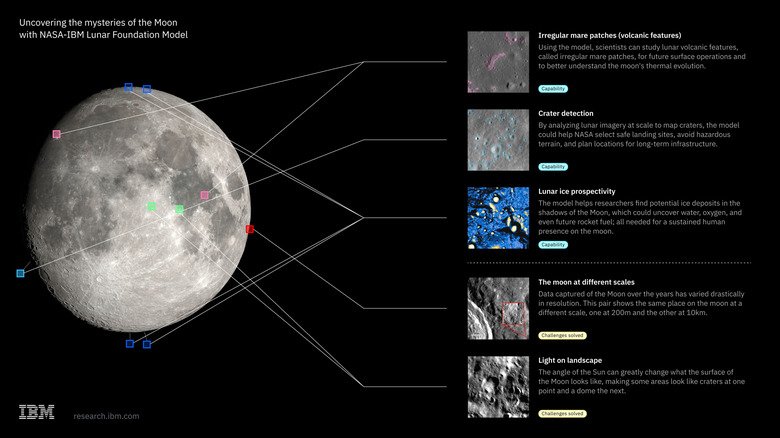
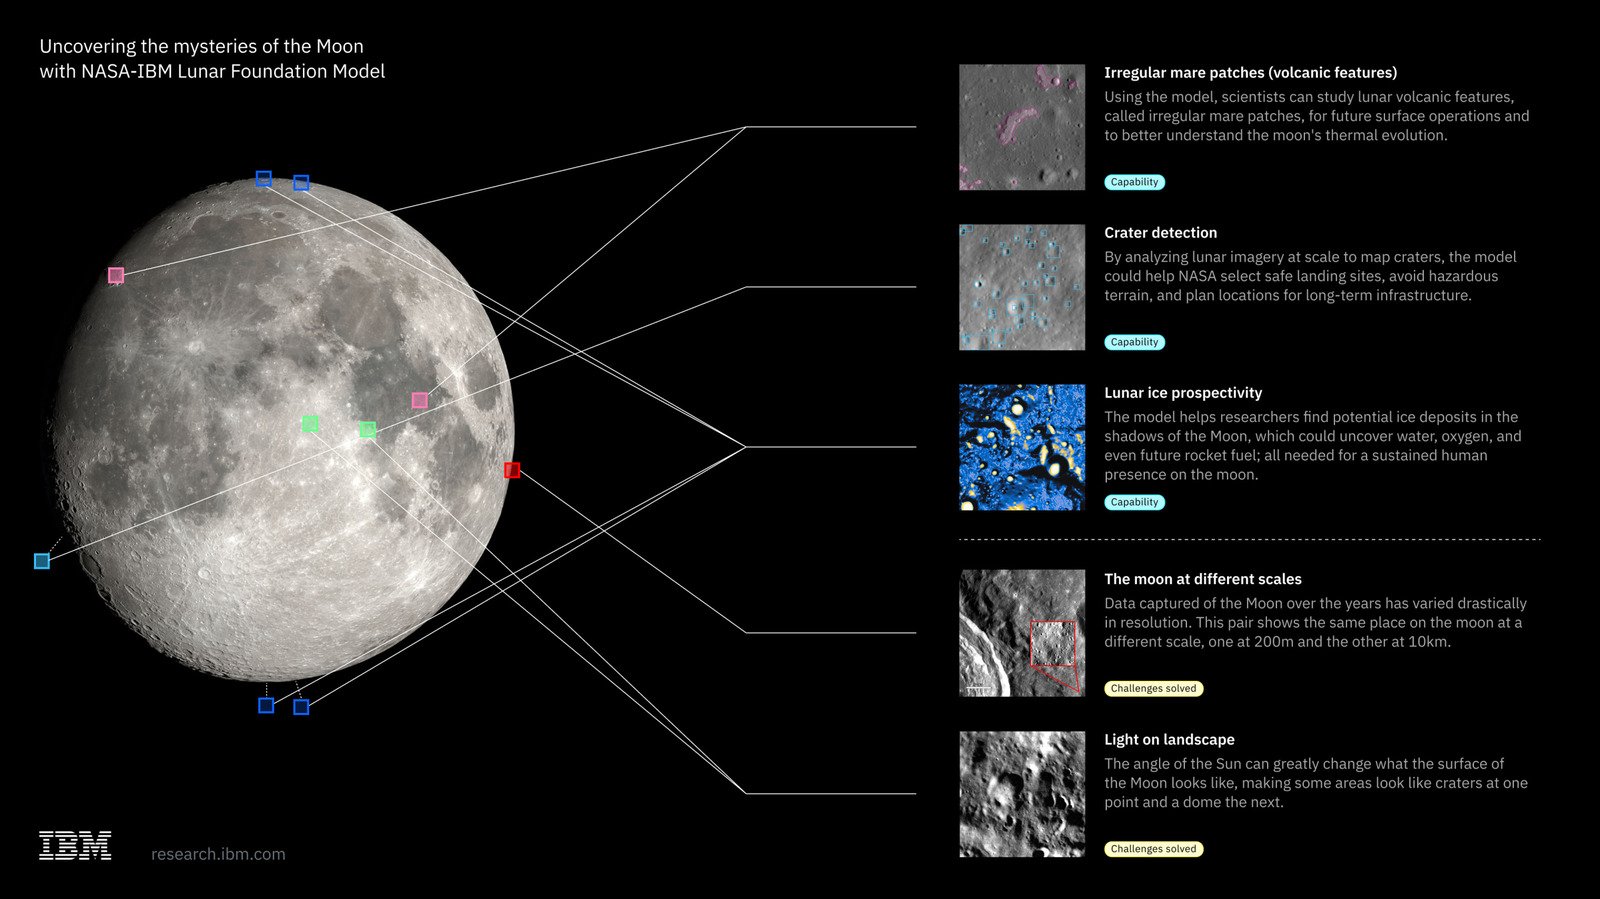
A ideia por trás de um foundation model é conhecida de quem mexeu com IA nos últimos anos: em vez de treinar uma rede neural para resolver uma tarefa específica, você treina um modelo amplo o suficiente para se adaptar a várias tarefas diferentes. Segundo Juan Bernabé-Moreno, diretor do IBM Research Europe para Reino Unido e Irlanda, o novo sistema mostrou desempenho especialmente bom numa função estratégica: apontar regiões da superfície lunar onde pode existir gelo.
Isso não é detalhe menor. O gelo de água em crateras permanentemente sombreadas nos polos lunares é uma das peças centrais dos planos de ocupação humana de longo prazo — ele serve para produzir água potável, oxigênio respirável e hidrogênio como combustível.
Testes, benchmarks e uma cratera inesperada
Para validar o modelo, NASA e IBM compararam as previsões dele com um mapa gerado a partir de um fluxo científico já publicado, que combina dados de terreno, informação térmica e outras variáveis ambientais. Depois, colocaram o sistema para competir com o SwinV2-B, um modelo de visão computacional treinado pela Microsoft para processar imagens de alta resolução e que costuma servir de referência em tarefas de análise de imagem. O resultado: o modelo da NASA com a IBM reduziu os erros em 23%.
Na identificação e classificação de crateras, o desempenho foi igualmente sólido. O novo modelo superou o SwinV2-B em 19%, usando metade dos dados de treinamento. E houve um teste não planejado que acabou virando demonstração pública: em 5 de agosto, um foguete Falcon 9, da SpaceX, atingiu a superfície lunar. Quando a IBM alimentou o modelo com uma imagem do impacto, ele classificou corretamente o local como uma cratera nova — mesmo com a marca se sobrepondo a uma cratera que já existia ali. Acertou de primeira.
Por que treinar IA para a Lua é tão complicado
Aqui a coisa fica tecnicamente interessante. Em observação da Terra, as imagens disponíveis são relativamente limpas. A atmosfera do planeta espalha a luz solar e preenche as sombras com iluminação ambiente, o que suaviza as bordas e mantém alguma informação nos pixels escuros. Na Lua, não existe esse luxo: as sombras são cortantes, pretas de verdade, e os pixels sombreados simplesmente não carregam informação útil.
Some a isso o fato de o Sol incidir em ângulos diferentes ao longo do dia lunar. Uma mesma cratera pode parecer uma coisa em uma imagem e algo completamente distinto na seguinte. Modelos de visão computacional normalmente são treinados com uma técnica de mascaramento: remove-se parte da imagem e pede-se que a rede reconstrua o que falta com base nos padrões aprendidos. Só que na Lua isso não funciona, porque inúmeras crateras são visualmente quase idênticas quando fotografadas de órbita.
A tentativa de seguir o caminho tradicional foi, nas palavras do pesquisador, um desastre completo. A solução encontrada pela equipe foi geométrica e criativa: dividir a Lua em gomos, como se fosse uma laranja, e separar completamente os gomos usados no treinamento daqueles usados nos testes. Assim, o modelo ganhou consistência sem vazar informação entre as etapas.
O dataset aberto pode valer mais que o modelo
Talvez o ativo mais valioso desse anúncio não seja o modelo em si, mas a base de dados que vem junto. Trata-se de um conjunto de dados de código aberto inédito, reunindo dezenas de milhares de imagens e dados instrumentais das missões Lunar Reconnaissance Orbiter (LRO) e Gravity Recovery and Interior Laboratory (GRAIL), da NASA, além da japonesa SELENE.
Segundo Bernabé-Moreno, a ausência de um modelo lunar abrangente até hoje não era falta de algoritmo, e sim de organização. A equipe construiu uma grade em que cada pixel de imagem corresponde a outras modalidades de dados, criando um conjunto co-registrado com mais de dois milhões de pontos. É esse alinhamento que permite a um modelo cruzar informação de sensores distintos sem se perder.
O raciocínio por trás da liberação é pragmático. Modelos de IA envelhecem rápido e são substituídos por versões melhores a cada poucos meses. Dados bem organizados, por outro lado, continuam úteis por muito mais tempo — são eles que sustentam toda uma indústria de modelos. Com Artemis avançando e a corrida lunar ganhando novos participantes, ter uma base comum, aberta e verificável é provavelmente o tipo de legado que rende frutos por décadas.
Media
Fonte: Engadget